Détails de la leçon
Description de la leçon
Dans cette leçon, l’accent est mis sur la nécessité de s’intéresser aux rapports démographiques et technologiques issus de Google Analytics, tout en insistant sur leurs limitations. L’objectif n’est pas de rechercher la vérité absolue mais d’identifier des tendances ou des anomalies dans les données.
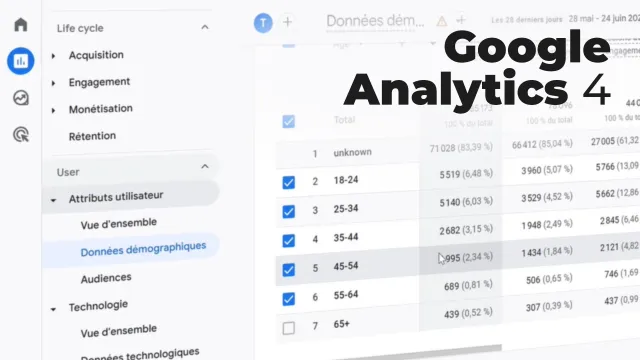
Le premier cas pratique aborde l’analyse démographique : face à un faible pourcentage d’une tranche d’âge dans le trafic, il serait erroné d’exclure ce segment du ciblage publicitaire sans prendre en compte la part non identifiée (« unknown »). Il est recommandé de comparer la répartition relative des tranches d’âge seulement parmi les utilisateurs identifiés, tout en tenant compte du seuil d’échantillonnage appliqué par Analytics. Ainsi, même des groupes apparemment minoritaires peuvent justifier une attention en matière de campagnes.
Le second exemple se concentre sur les données technologiques : l’analyse du trafic par modèle d'appareil révèle parfois des anomalies, telles qu'un nombre disproportionné d'utilisateurs provenant de modèles spécifiques (exemple : Nexus 5). Une analyse critique met en lumière la distinction possible entre trafic réel et trafic de test, incitant à relier les données quantitatives à leur contexte technique.
Au final, cette leçon met l’accent sur la nécessité de croiser les données et de contextualiser les informations issues d’outils analytiques pour orienter les décisions marketing et publicitaires, et non sur leur prise comme des vérités statistiques absolues.
Objectifs de cette leçon
L’objectif principal de cette vidéo est de permettre aux professionnels du marketing digital de comprendre l’interprétation critique des rapports démographiques et technologiques de Google Analytics, afin d’éviter des erreurs d’exclusion de segments et de mieux détecter les anomalies pertinentes dans l’audience d’un site web.
Prérequis pour cette leçon
Avoir des connaissances de base en web analytics, comprendre les notions de trafic web et connaître le fonctionnement général de Google Analytics. Une familiarité avec le vocabulaire du marketing digital et la configuration de campagnes publicitaires est souhaitée.
Métiers concernés
Les compétences abordées ici sont utiles pour les trafic managers, analystes de données web, consultants SEO/SEA, chefs de projet digital et tous les professionnels cherchant à optimiser le ciblage publicitaire et la compréhension de l’audience en ligne.
Alternatives et ressources
Outre Google Analytics, il existe des solutions telles que Matomo, Adobe Analytics ou Piwik PRO pour l’analyse du trafic et des comportements utilisateurs. D’autres outils spécialisés, comme Hotjar ou Mixpanel, permettent d’approfondir la compréhension des parcours visiteurs.
Questions & Réponses
 Je m'abonne